의협의 이번 계간 의료정책포럼에 제가 기고한 글입니다. ‘인공지능이 의사를 대체하는가’라는 주제로 원고를 써달라고 요청을 받았는데요. 제가 평소에 블로그, 칼럼 및 강의에서 강조해오던대로, 대체는 이미 진행되고 있으며, 이제는 질문 자체를 바꿔야 한다는 논지로 기고하였습니다.
—
인공지능이 의사를 대체할 수 있을 것인지는 흥미롭고도, 중요하고, 또 예민한 문제이다. 더 나아가면 의학적으로 이것이 (적어도 특정 상황, 특정 환경에서라도) 가능하다고 증명하기가 아주 어려운 문제이기도 하다. 2010년대 중반 의료 인공지능 분야의 초창기에도 이런 질문이 많이 나왔었지만, 일종의 흥미 위주의 질문이기도 했고 또 의료계에서 예민하게 반응할 수도 있는 질문이었기 때문에 이를 직접적으로 그리고 진지하게 다루는 경우는 많지 않았다. 하지만 이 분야의 발전이 지속되면서, 이제는 주류 의료계와 연구에서도 이런 질문들이 진지하게 논의되기 시작했다.
그런데 필자는 이 질문 자체가 잘못 되었다고 생각한다. ‘의사’는 단일한 직무가 아니라 성격이 전혀 다른 수백 가지 과업의 묶음이기 때문이다. 유방촬영술 판독, 당뇨성 망막병증 선별, 처방 갱신, 예후에 대한 설명, 임종기 상담, 수술 중의 판단, 더 나아가서 자동 수술 등은 각각 자동화의 가능성이 완전히 다르다. 이렇게 이질적인 과업들을 하나로 묶어놓고 ‘대체되는가’를 묻는 것은, 애초에 답을 얻기 어려운 질문인 것이다.
다만 질문이 잘못되었다는 것이, 그 답이 ‘아니오’라는 뜻은 결코 아니다. 오히려 과업 단위로 쪼개어서 보면 몇몇 영역에서 인공지능은 이미 의사를 대체했다. 결론부터 이야기하자면, 이제 더 중요한 질문은 ‘대체하는가’가 아니라 ‘무엇을, 어느 정도의 자율도까지, 누구의 책임으로 위임할 것인가’이다.
루닛의 인공지능이 영상의학과 의사를 대체하다
인공지능이 의사를 대체하는 가장 대표적인 사례는 스웨덴에서 나왔다. 스톡홀름의 Capio Sankt Göran Hospital 연구진이 루닛의 유방촬영술 인공지능 INSIGHT MMG를 독립적인 판독자로 활용하여 진행한, 소위 ScreenTrustCAD 연구이다. 2023년 Lancet Digital Health에 출판된 이 연구의 가장 큰 의미는 바로 전향적(prospective) 연구라는 점이다. 그동안 유방촬영술에서 인공지능의 정확도가 영상의학과 전문의와 비견할 수 있을정도로 높다는 것은 몇몇 연구에서 증명되어 왔지만 대부분 후향적(retrospective) 연구였다는 한계가 있었기 때문이다. 유럽에서는 유방촬영술 검진에서 영상의학과 전문의 2인의 이중 판독(double reading)이 표준 프로토콜(standard-of-care)인데, 이 연구는 40~74세 여성 55,581명을 대상으로 그중 한 명을 인공지능으로 대체했을 때 암 검출률이 열등하지 않은지(non-inferior) 밝히는 것이 일차 평가변수(primary outcome)였다.
결과는 단순한 비열등성의 증명을 넘어섰다. 전문의 2명의 이중 판독이 250명의 암을 검출한 데 비해, 전문의 1명과 인공지능의 조합은 261명을 검출하였다. 단순히 비열등할 뿐만 아니라(relative proportion 1.04) 통계적으로 유의미하게 더 우월하다(p=0.017)는 것까지 증명한 것이다. 참고로 참여한 영상의학과 전문의는 총 11명, 경력의 중간값은 17년이었다.
더 흥미로운 것은 두 번째 비교이다. 영상의학과 전문의를 아예 배제하고 인공지능 단독으로 판독한 경우에도 246명의 암을 검출하여 암 검출률이 대조군의 98%(relative proportion 0.98)에 해당하는 것으로 나타나, 비열등성(p<0.0001)이 입증된 것이다. 다만 이 경우 더 우월하지는 않았다(p=0.73). 그런데 여기서 또 다른 흥미로운 결과가 발생한다. 판독자가 한 명뿐이므로 위양성(false positive)이 적을 수밖에 없어서, 환자의 재소환 횟수가 거의 절반인 47%나 줄어드는 것이다. 이는 환자에게 불필요한 걱정을 끼치거나 비용을 발생시키는 일 역시 절반으로 줄어든다는 뜻이므로, 적지 않은 의미가 있다.

이 병원은 논문을 출판하는 것에 그치지 않았다. 2023년 중반부터 실제로 유방암 검진에서 영상의학과 의사 한 명을 루닛의 인공지능으로 대체하였다. 인공지능을 독립적인 판독자로 활용하여 영상의학과 전문의를 대체한 세계 최초의 병원이 된 것이다. RSNA 2024에서 발표된, 도입 전 9개월과 도입 후 9개월을 비교한 실세계 데이터(real-world data)를 보면, 양성예측도(PPV)는 16.9%에서 22.1%로, 암 발견율은 10만 명당 4.8건에서 5.5건으로 개선되었고, 전체 판독 시간은 36%나 단축되었다.
이 정도가 되면 인공지능이 더 이상 ‘보조’에만 머무른다고 보기는 어렵다. 표준 진료 프로토콜에서 전문의 한 명의 자리를 인공지능이 채웠으며, 그 결과는 오히려 개선되었기 때문이다.
의사 <<< 의사+AI <<< AI
의료 인공지능 분야 초창기의 연구 결과들은 대부분 하나같이 유사했다.
의사 < AI < 의사 + AI
즉, AI가 의사보다 낫기는 하지만 그래도 의사와 AI의 시너지가 있어서, 서로 힘을 합친 결과가 가장 좋다는 것이었다. 어찌보면 자연스럽고도, 논리적이고, 또 직관에도 반하지 않는, 불편하지 않은(?) 결론이다.
하지만 인공지능 기술이 더욱 발전하면서 이제는 조금씩 다른 결론이 나오고 있다. 이러한 흐름을 뒷받침하는 논문이 2025년 npj artificial intelligence에 출판되었는데, 흥미롭게도 의사, AI, 의사+AI 세 그룹을 모두 분석한 기존 논문들을 메타 분석한 체계적 문헌 고찰(systematic review)이다.
이 연구는 총 3,191편을 검토하여 최종적으로 52편을 분석하였다. 모두 합하면 천 명이 넘는 의사와 약 35,000건의 진단 케이스가 된다. 일단 의사 단독 대비, 의사+AI의 시너지는 다시 한 번 증명되었다. 하지만 의사+AI는 AI 단독과 비슷하거나 오히려 더 못했다.
그리고 가장 흥미롭고도, 예상하지 못했으며, 어찌 보면 좀 불편할 수도 있는 결론이 여기에 있다. 바로 AI가 인간의 실력을 더 크게 능가할수록 의사+AI의 시너지(complementary ratio)는 오히려 줄어드는 경향이 있었다는 것이다. 즉, 의사와 AI의 실력 격차가 크면 클수록 인간의 개입이 AI의 성능을 ‘더 많이’ 깎아먹었다는 뜻이다. 앞으로 AI는 더 크게 발전할 것이 자명하므로, 향후 의사+AI < AI의 격차는 시간이 갈수록 더욱 벌어질 것이라는 점을 추정해볼 수 있다.

같은 방향의 근거는 전혀 다른 연구에서도 나온다. OpenAI가 2025년 5월 공개한 헬스벤치(HealthBench)는 한국을 포함한 60개국 262명의 의사가 참여해 만든 5,000개의 의료 대화와 48,562개의 채점 기준표(rubric)로 구성된 방대한 벤치마크이다. 여기서 가장 성적이 좋지 않았던 것은 인공지능의 도움 없이 의사가 직접 답변을 작성한 그룹이었다. 그리고 흥미롭게도 2024년 버전의 GPT를 참고한 경우에는 시너지가 있었지만, 2025년 4월 버전의 GPT-4.1 및 o3를 참고한 경우에는 의사가 검토해서 수정·보완한 답변과 모델 단독의 답변 사이에 점수 차이가 거의 없었다. 시너지가 불과 1년 사이에 사라진 것이다. Nature Medicine에 발표된 RCT에서도 관리 추론(management reasoning) 문제에서 GPT-4 단독과 GPT-4의 보조를 받은 의사의 점수 차이가 없었다.

물론 이 결과들에 대해서는 조심스러운 해석이 필요하다. 세 가지 한계를 함께 짚을 수 있다. 첫째, HealthBench나 관리 추론 문제에서 측정한 과업은 의사들이 평소에 수행하는 작업이 아니다. 대화의 마지막 질문에 텍스트로 답변하는 식으로 진료를 하지 않기 때문이다. 이 과업은 신체 진찰도, 비언어적 단서도, 경과 관찰도 동반되지 않는다. 둘째, 벤치마크를 만든 주체와 가장 높은 점수를 받은 모델의 소유자가 동일하다. 심판과 선수를 모두 같은 회사에서 맡았다고 해석될 수도 있는 부분이다.
그리고 셋째가 가장 근본적인 문제인데, 이 모든 근거가 ‘과거’의 것이라는 점이다. 현대 의학의 가장 중요한 원칙 중의 하나가 근거 중심 의학이다. 그런데 의료 인공지능과 같이 기술이 빠르게 발전하는 분야에서 미래를 논하기 위한 가장 큰 어려움이 바로 여기에 있다. 그것도 ‘기술 격차가 시간에 따라 더욱 크게 벌어지는’ 과거의 시점에서 나온 근거라는 것이다. 마치 백미러를 보면서 운전을 해야 하는 상황과 비슷하다.
그럼에도 그 방향성 자체를 부정하기는 어렵다. 필자는 인공지능 기술이 더욱 발전하면서 의사와 인공지능의 격차가 더욱 벌어지게 될 것이라고 예상해 왔다. 이를 표현하자면 아래와 같다.
의사 <<< 의사+AI <AI
그리고 이번에 소개한 논문을 보면, 여기에서 한 걸음 더 나아가서, 앞으로 인공지능이 더욱 발전하면 의사+AI와 AI 단독의 실력 격차도 더 크게 벌어질 것이라는 점도 유추해볼 수 있다. 표현하자면 아래와 같다.
의사 <<< 의사+AI <<<AI
그리고 ‘<<<‘의 부등호 개수는 가면 갈수록 더욱 많아질 것이다. 우리는 이제 이 시대를 대비해야 한다. 특히, 이러한 부등호의 개수만 더 많아지는 것이 아니라, 이제 의료 인공지능은 ‘자율성’을 지니는 단계로 나아가고 있다.
자율 의료 인공지능이 온다
사실 의사의 ‘개입 없이’ 임상적인 결론을 내리는 인공지능이 규제 기관의 허가를 받고 현장에까지 도입된 사례는 이미 적지 않다. FDA가 2018년 De Novo로 승인한 루미네틱스코어(LumineticsCore, 많은 분들께는 허가 당시의 이름인 IDx-DR이 더 익숙하실 것이다)는 당뇨병 환자의 안저 사진으로 중증 당뇨성 망막병증 여부와 안과 전문의 의뢰의 필요성을 의사 없이 판정한다.
영국 스킨 애널리틱스의 피부암 진단 인공지능 덤(DERM)은 한 걸음 더 나아가, 2025년 EU에서 가장 높은 위험 등급인 Class III CE Mark를 받고 NICE로부터 3년의 조건부 사용과 건당 £5.90의 보험 급여까지 인정받았다. 특히 주목할 것은 NHS 잉글랜드의 공식 권고 에 포함된 문장이다. “덤이 처음 도입될 때는 2차 임상 판독을 병행하는 방식으로 사용을 고려해야 한다. 일단 덤에 대한 현장의 신뢰도가 생기면, 자율 사용으로 전환할 수 있다.” 이렇게 의사의 개입 없이 의학적인 의사결정을 내릴 수 있는 인공지능이 이미 의료 현장에 도입되고 있는 것이다.
그런데 여기서 한 가지 의문이 생긴다. 루미네틱스코어와 덤과 같은 인공지능이 이미 자율적으로 판단을 내리고 있었다면, 왜 지금 다시 ‘자율 의료 인공지능’을 논해야 할까. 바로 기존의 자율 인공지능과 최근에 대두되는 자율 인공지능 사이에 근본적인 차이가 있기 때문이다.
첫째는 사용 목적(intended use)의 범위이다. 루미네틱스코어는 당뇨성 망막병증, 덤은 피부암으로 사용 목적이 국한되어 있다. 반면 새로운 자율 인공지능은 1차 진료 전반처럼 열려 있으며(open-ended), 적어도 특정 범위 내에서는 범용적(general-purpose)이라고까지 표현할 수 있다.
둘째는 알고리즘이 얼마나 고정(static)되어 있는가이다. 기존의 의료 인공지능은 배포 시점에 동결되는 소위 ‘잠겨 있는 알고리즘(locked algorithm)’을 전제하며, FDA의 PCCP 제도가 허용하는 변경도 제조사 통제 하의 명시적 업데이트에 한정된다. 반면 생성형 인공지능 기반의 시스템은 프롬프트, RAG(검색 증강 생성), 도구 호출 로직, 가드레일 등 여러 층이 각각 독립적으로, 자주 변경된다. 이런 점을 고려하면 이 모델은 일종의 동적인 유기체에 가깝다.
셋째는 출력의 재현성이다. 같은 안저 사진을 루미네틱스코어에 100번 넣으면 100번 모두 동일한 결과가 나온다. 하지만 LLM은 다음 단어(더 정확히는, 토큰)를 확률 분포에서 샘플링해서 생성하기 때문에, 온도(temperature)를 0으로 설정해도 여러 단계의 추론과 도구 호출을 거치는 멀티 에이전틱 구조에서는 출력의 변동이 누적된다.
여기서 주목해야 할 점이 있다. 결국 이 세 가지 차이가 모두 ‘인공지능이 사람 의사를 닮아가고 있다’는 방향이라는 것이다. 사람 의사도 범용적이고, 새로운 근거를 흡수하면서 판단이 바뀌며, 같은 환자를 보더라도 매번 조금씩 다른 판단을 내릴 수 있기 때문이다.
이러한 새로운 자율 의료 인공지능의 대표적인 사례가 2026년 6월 네이처에 발표된 MIRA(Medical Intelligence for Reasoning and Action)이다. 독일 드레스덴 공대와 하이델베르크대 병원 연구진이 발표한 이 에이전트는 전자의무기록(EHR)과 통합되어 스스로 병력을 청취하고, 검사를 오더하고, 결과를 해석하며, 감별 진단을 내리고, 처방과 입원 결정까지 수행한다. 11가지 도구를 호출해서 85,000개가 넘는 임상적인 행동 공간(action space)에서 자율적으로 의료 행위를 하는 것이다. 그 결과, 8개 응급질환 574개 사례에서 MIRA는 87.8%의 진단 정확도로 7~11년 경력 전문의 그룹(78.1%)과 혼합 경력 그룹(71.1%)을 모두 상회했고, 가이드라인 준수와 약물 안전성, 입원 판단에서도 의사 그룹과 동등하거나 더 우월했다. MIRA는 아직 실제 환자가 아니라 샌드박스 안의 통제된 환경에서의 성과라는 점은 분명히 해야 하겠다. 하지만 자율 의료 인공지능의 가능성과 미래에 의료 시스템에서 자율 의료 인공지능이 어떠한 방식으로 구현될지에 대한 구체적인 그림을 보여준다는 점에서 큰 의의를 지닌다.
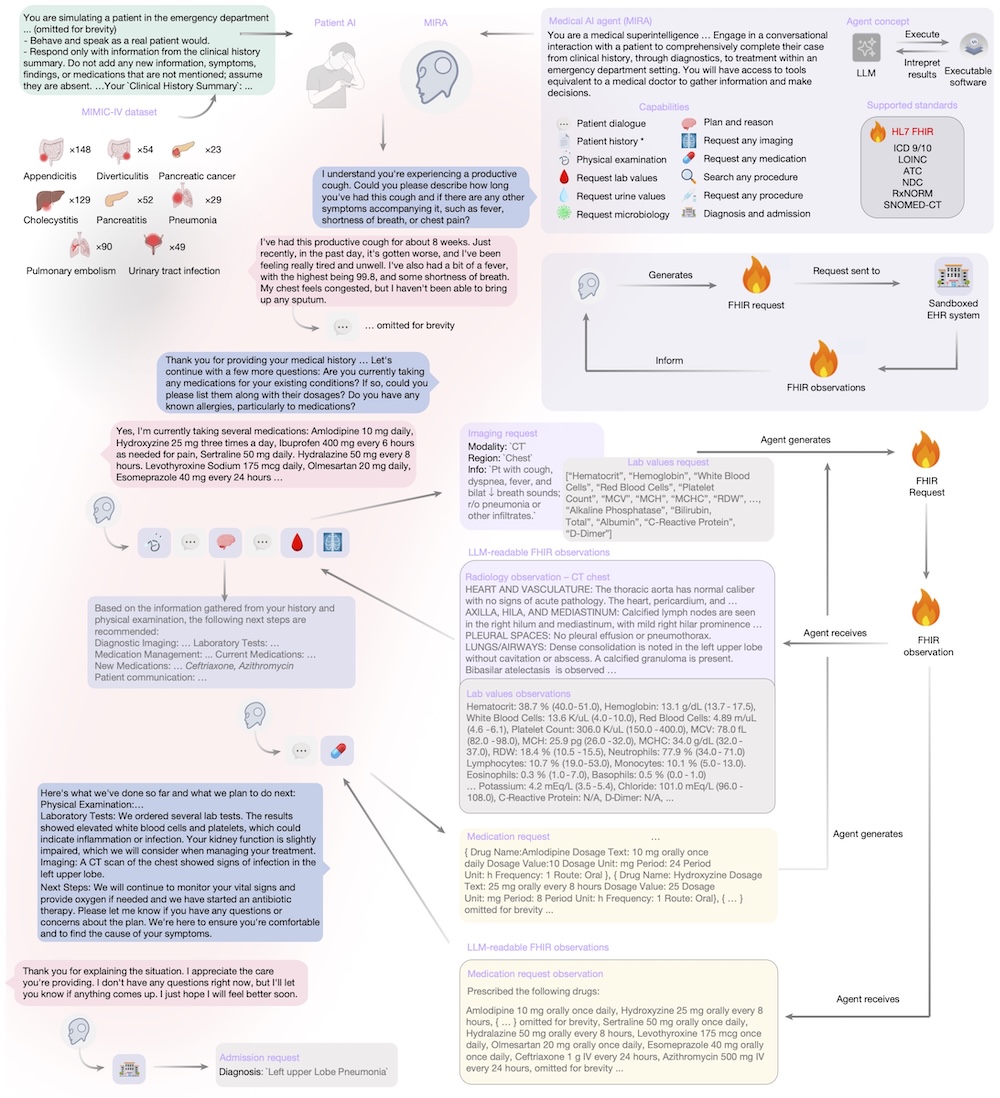
자율 처방을 허용한 유타주
MIRA가 샌드박스 속에서 구현된 연구라면, 의료 현장에는 자율 의료 인공지능의 대표 주자인 닥트로닉(Doctronic)이 많은 화제와 논란을 불러일으키고 있다. 2026년 1월, 유타주 상무부는 ‘인공지능 정책 샌드박스’라는 규제 면제 프로그램을 통해서 닥트로닉이라는 회사의 인공지능이 고혈압, 당뇨, 천식 등 만성질환 192종 약물의 리필 처방을 ‘의사 없이’, 그것도 단돈 4달러의 비용으로 결정하도록 허용했다. 닥트로닉은 100개 이상의 에이전트로 구성된 멀티 에이전틱 시스템으로 알려져 있다.
필자는 이것이 하나의 선을 건넌 사건이라고 본다. 인공지능이 의학적 의사 결정을 스스로 내릴 수 있도록 법적으로 허용한 미국 내 최초의 주 승인 프로그램이기 때문이다. 앞서 살펴본 루미네틱스코어나 덤은 좁은 범위에서 특정 질병을 진단하는 데 그쳤다. 하지만 닥트로닉은 다양한 만성질환이라는 보다 더 범용적이고 개방적인 환경에서 자율적으로 의학적인 의사 결정을 내리고 있다. 이는 의심할 여지 없이 ‘의료 행위’이며, 그동안 어느 나라에서도 인간에 의해서만, 특히 ‘면허’를 가진 인간에 의해서만 이뤄졌던 행위이다. 그런 의료 행위가 이제 제한적인 조건 하에서나마 알고리즘에게 허용된 것이다.
그렇다면 유타주는 무엇을 근거로 이런 결정을 내렸을까. 바로 닥트로닉의 인공지능이 인간 의사의 치료 권고안과 99% 이상 일치한다는 수치였다. 그 출처는 2025년 7월 medRxiv에 등재된 프리프린트인데, 이 논문을 직접 읽어보면 몇 가지 흥미로운 것들이 보인다.
이 연구는 연속된 500건의 비대면 급성진료(urgent care) 사례를 후향적으로 분석하여 닥트로닉과 전문의 자격을 갖춘 임상의를 비교하였다. 최상위 진단이 일치한 비율은 81%, 치료 계획이 일치한 비율이 99.2%였다. 즉, 유타주가 인용한 ‘99%’는 진단 일치율이 아니라 치료 계획 일치율이다. 연구의 설계에도 짚을 점이 몇 가지 있다. 다룬 것은 (주로 경증의) 급성 진료이지 이번에 허용된 만성질환의 처방 갱신이 아니고, 비교 대상인 임상의들은 환자를 진료하기 전에 인공지능이 작성한 진료 문서를 미리 제공받았으며, 저자 8인 전원이 닥트로닉의 지분 보유자이다. 후향적 연구이며 동료 심사(peer-review)도 거치지 않았다.
다만, 이 지점에서 함께 생각해야 할 것이 있다. 우리가 자율 인공지능에게 요구하는 기준이 과연 인간 의사에게 적용하는 기준과 같은가 하는 문제이다. 2025년 npj Digital Medicine의 한 논평은 이를 정면으로 지적한다. 인간 의사의 처방 오류율은 연구에 따라 5~9%에 이르고, 항생제의 과처방이나 오피오이드 위기는 다름 아닌 인간 의사가 만들어낸 결과이다. 그렇다면 인공지능의 자율 처방이 본질적으로 더 위험하다고 단정할 근거는 무엇인가. 실제로 앞서 언급한 닥트로닉의 연구에서도, 인간과 인공지능의 판단이 불일치한 사례를 전문가가 다시 검토했을 때 오히려 인공지능이 우월한 경우가 36.1%인 반면, 인간이 우월한 경우는 9.3%에 그쳤다. 불일치가 곧 인공지능의 오류를 의미하지는 않는 것이다.
물론 유타주의 이러한 결정에 대해서는 곧바로 반발이 나왔다. 유타주 의료 면허 위원회는 2026년 4월 즉각 중단을 요구한 것이다. 처방 갱신이 단순 반복 행위가 아니라 용량 조정이나 부작용 모니터링과 같은 실질적인 임상 판단을 요구한다는 것, 그리고 의료 행위임에도 면허 위원회와 사전 협의가 없었다는 것이 그 근거였다. 학계에서도 같은 지적이 나왔다. 스탠퍼드 의과대학 및 로스쿨의 미셸 멜로(Michelle Mello) 교수는 JAMA Health Forum에서 근거의 적용 범위와 이해상충의 문제를 짚었고, 2026년 4월 JAMA에 실린 ‘최초의 AI 약물 처방자(The First AI Drug Prescriber)’는 연방 처방법상 인공지능이 ‘면허 받은 임상의(licensed practitioner)’가 아니므로 처방 행위 자체가 불법이라는 점을 지적하였다.
하지만 이미 물꼬가 터진 이상, 이 흐름이 여기에서 멈출 것이라고 보기는 어렵다. 실제로 유타주는 닥트로닉을 허용한 이후에, 2026년 4월에는 정신과 약물 리필 처방을 레지온 헬스(Legion Health)의 ‘자율적인’ 판단에 맡기기로 했다. 월 19불에 프로작, 졸로프트, 웰부트린 등 저위험 약물 15종에 대해서 유타주 주민에게 1년 동안 파일럿으로 리필 처방을 시작했다.
더 나아가, 2026년 9월 미국 정부 기관 ARPA-H는 심부전에 대한 중증도 평가, 약물 처방, 검사 오더를 자율적으로 수행하는 인공지능 의료기기를 개발하고 FDA 승인을 받는 것을 목표로 6,270만 달러를 투입하기로 결정했다. 여기에는 템퍼스와 같은 기업, 그리고 스탠퍼드, 듀크 대학 및 카이저 퍼머넌트와 같은 의료 시스템이 지원 대상으로 발표되었다. 또한 2026년 8월 FDA가 발표한 생성형 인공지능 기반 의료기기의 규제 방안에 대한 토의 문서(discussion paper)에도 자율성을 가진 의료 인공지능을 향후 어떻게 규제할 것인지에 대한 고민이 중요하게 다뤄지고 있다.
미국의사협회, 자율 의료 인공지능을 정의하다
자, 그렇기 때문에 우리는 다시 중요하고도 핵심적인 질문을 던질 수밖에 없다. 인간 의사의 개입 없이 자율적이고 독립적으로 임상적인 의사 결정을 내리고 의료 행위를 수행할 수 있는 이 ‘존재’를, 우리는 어떻게 정의하고 규정해야 할까.
놀랍게도 입법을 통한 시도가 이미 있었다. 2025년 1월 발의된 ‘Healthy Technology Act of 2025’는 FDA의 승인·허가를 받고 주 법률에 따라 처방 권한을 부여받은 인공지능을 ‘해당 의약품을 투여할 수 있도록 법률상 면허를 받은 의료인(practitioner)’에 포함시킬 것을 제안했다. 330자 분량의 아주 짧은 법안이지만 너무도 파격적인 내용이다. 다만 이 법안은 아직 통과되지 않았다.
그런데 정작 가장 정교한 준비를 해둔 곳은 입법부가 아니라 미국의사협회였다. 더욱 흥미로운 것은 그 주체가 신규 시술에 대한 CPT 코드의 심의와 승인을 담당하는 CPT 편집위원회(CPT Editorial Panel)라는 점이다. 이 위원회는 2022년 1월 ‘의료 서비스 및 시술을 위한 AI 분류 체계’, 즉 CPT Appendix S를 공식적으로 발효하였다.
CPT Appendix S에서는 의료 인공지능을 셋으로 분류한다. 임상적으로 관련 있는 데이터를 탐지(detect)하는 데 그치는 보조(assistive), 데이터에 대한 분석 및 정량화를 제공하되 그 해석과 보고는 의사가 하는 증강(augmentative), 그리고 의료 전문가의 동시적(concurrent) 개입 없이 자동으로 데이터를 해석하고 임상적으로 의미 있는 결론을 독립적으로(independently) 생성하는 자율(autonomous)이다.
그런데 Appendix S는 여기에서 그치지 않는다. 한 단계 더 나아가서 ‘자율’에 해당하는 인공지능의 자율도(level of autonomy)를 다시 세 단계로 구분한다. 마치 자율주행차의 자율도를 레벨 5까지 구분하고 있는 것과 유사하다.
- Level I: 인공지능이 결론을 도출하고 진단 및 관리 옵션을 제시(offer)한다. 실제로 실행하기 위해서는 의사의 행동이 필요(require)하다.
- Level II: 인공지능이 결론을 도출하고 진단 및 관리 옵션을 개시(initiate)한다. 이는 무효화(override)할 수 있도록 경고와 기회가 제공된다.
- Level III: 인공지능이 결론을 도출하며 관리를 개시한다. 이에 이의를 제기하기 위해서는 의사가 능동적으로 먼저 행동해야(initiative to contest) 한다.
여기서 중요한 사실이 하나 있다. Level II와 III에 해당하는 자율 의료 인공지능은 아직 규제 기관의 허가를 받거나 의료 현장에 도입된 것이 없다. 즉, 미국의사협회가 아직 존재하지도 않는 자율 인공지능을 사전에 분류하고 정의까지 해놓은 것이다. FDA도 2026년 8월에야 자율 의료 인공지능을 본격적으로 논의하기 시작했다는 것을 고려하면, 미국의사협회의 이런 움직임은 놀랍다고 할 수 있다.
그리고 이 정의는 문서에만 남지 않았다. 루미네틱스코어에 부여된 CPT 코드 92229는 2020년 9월 신설 당시 “현장 자동(automated) 분석 및 보고서”로 기술되었다가, Appendix S 발효 이후인 2022년 9월 “현장 자율(autonomous) 분석 및 보고서”로 수정되었다. ‘자동’과 ‘자율’은 일견 비슷해 보일 수도 있지만, 잘 생각해보면 ‘자동’은 지정된 조건에 따라 수행한다는 의미인 반면 ‘자율’은 어떻게 수행할 것인지, 혹은 수행할 것인지 자체에 대해서도 의사결정권을 가질 수 있다는 의미이다. 단어 하나가 행위의 성격을 규정하는 것이다.
청진기에는 위임하지 않는다
그렇다면 미국의사협회는 인공지능을 의료 행위의 ‘주체’로 인정한 것일까. 그렇지 않다. Appendix S의 자율 인공지능에 관한 정의를 자세히 들여다보면 “의사 또는 기타 의료 전문가를 대신하여(on behalf of) 기계가 수행한 작업”이라는 표현이 등장한다. 여기서 중요한 것이 바로 ‘on behalf of’인데, 이는 법적으로 위임(delegation) 관계를 의미한다. 즉, 의료 행위의 주체는 여전히 의사이고 인공지능은 그 의사가 위임한 작업을 수행하는 도구에 지나지 않는다는 것이, 회원인 의사의 직업적 지위와 권한을 대변해야 하는 미국의사협회의 입장인 셈이다.
하지만 역설적으로, 이런 ‘위임’ 관계를 암시하는 표현 자체가 인공지능이 단순한 도구가 아니라 의료 행위의 일부를 실제로 수행하는 행위자에 가까운 무엇임을 인정한 것이라고도 할 수 있다. 왜냐하면 위임은 행위 능력이 있는 존재 사이에서만 성립하기 때문이다. 예를 들어, 의사는 청진기에 무엇인가를 위임하지 않고 MRI 기계에도 무엇인가를 위임할 수 없다. 하지만 대학병원 교수는 전공의나 인턴 의사에게 무엇인가를 위임할 수 있다. 전공의나 인턴은 행위 능력이 있는 존재이기 때문에 이런 위임 관계가 성립한다. 자율 인공지능도 그러하다는 것이다.
의사의 노동은 0으로 계산되었다
더 나아가서, CPT 코드 92229의 수가 책정 방식을 보면 매우 중요한 함의가 담겨 있다. 메디케어 수가는 기본적으로 세 가지 상대 가치 단위(RVU)의 합, 즉 의사의 시간·기술·노력·임상적 판단을 반영하는 ‘의사 업무 RVU’, 인력과 장비 비용을 반영하는 ‘진료 비용 RVU’, 배상책임 위험도를 반영하는 ‘의료 사고 비용 RVU’로 구성된다.
흥미로운 것은 CMS가 92229의 수가를 산정할 때 ‘의사 업무 RVU’를 0으로 계산했다는 점이다. 즉, 이 행위에서 의사가 쓰는 시간, 기술, 노력, 임상적 판단은 ‘없다’고 결정한 것이다. 미국의사협회의 주장대로 의사가 인공지능에게 ‘위임’하는 관계라면 이 값이 0이어서는 안 된다. 실제로 PA나 NP에게 작업을 위임할 때에도 의사가 감독(supervision)의 책임을 진다면 ‘의사 업무 RVU’를 일부라도 받는다. 그런데 92229는 0이다. 대신 수가의 대부분은 진료 비용 RVU가 차지한다. 즉, ‘의사가 일을 위임하는 비용’이 아니라 ‘AI가 일을 수행한 비용’을 보상하고 있는 것이다. 돈의 흐름을 기준으로 보면 CMS는 ‘AI가 독립적 행위 주체로서 의료 행위를 수행한다’는 것을 사실상 인정하고 있는 셈이다.
정리하자면, 현재 미국의사협회의 정의(의사가 인공지능에게 위임한다)와 CMS의 수가 산정에 대한 판단(의사의 노동이 전혀 수반되지 않는다)이 서로 정면으로 충돌하고 있는 과도기적인 상황인 것이다. 그러면서도 92229의 수가를 청구하는 주체는 여전히 의사이다. 의사의 노동이 0인 행위를 왜 의사가 청구해야 하는가. 그리고 여기서 의료 과실이 발생했을 때 그 책임 소재는 누구에게 있는가. 미국의사협회의 위임 논리를 따르면 의사일 것이고, CMS의 급여 산정 모델을 따르면 의사가 아니라고 봐야 할 것 같다.
이렇게 자율 의료 인공지능이 대두하기 시작하면서, 현재는 과도기적인 상황을 지나고 있다. 앞서 언급했듯이 이제는 ‘인공지능이 의사를 대체하는가’는 더 이상 중요한 질문이 아니며, 이제는 ‘의사의 역할 중에 무엇을, 어느 정도의 자율도까지, 누구의 책임으로 위임할 것인가’라는 더 중요한 질문을 던져야 할 때이다. 기술이 발전함에 따라서, 의료가 이 방향으로 나아가는 것을 결국에는 불가피하며, 이를 위한 제도적, 윤리적, 법적인 준비가 필요하다.
누가 주도할 것인가
미국의사협회의 행보에서 우리가 읽어야 할 것은 기술에 대한 저항이나 항복이 아니라 ‘주도권’이다. 무엇을 자율이라 부를지, 어느 단계까지를 위임으로 볼지, 어디서부터는 위임이 아닌지를 자신들이 먼저 정의해 두면, 이후의 인허가와 수가와 책임에 대한 논의가 모두 그러한 체계 위에서 진행되기 때문이다. 아직 존재하지도 않는 Level II, III를 2022년에 미리 분류해 둔 것은 그런 계산이라고 볼 수 있다.
그렇다면 한국의 상황은 어떤가. 흥미롭게도 규제 대응의 속도만 놓고 보면 한국은 오히려 앞서 있는 편이다. 식약처는 2025년 1월 생성형 인공지능 의료기기에 대한 허가·심사 가이드라인을 세계 최초로 내놓았고, 이번 2026년 6월에는 LLM 기반 디지털 의료기기 허가·심사 가이드라인까지 내어놓았다. 아직 미국과 유럽 모두 생성형 인공지능 기반 의료기기의 규제 방안에 대해서는 의견 수렴 단계인 것을 감안하면, 한국이 크게 빠르게 움직이고 있는 것이다. 더나아가, 신의료기술평가 유예를 비롯한 선진입 제도가 도입되고 있으며, 여기에 정부는 2026년 7월 「AI 기본 의료 전략」을 발표하며 국가가 의료 인공지능의 ‘지불자’가 되는 방향까지 제시하였다. 인허가, 시장 진입과 지불의 틀이 모두 만들어지고 있는 것이다.
문제는 그 틀을 누가 어떤 식으로 기술할 것인가이다. 특정 인공지능이 보조인지, 증강인지, 자율인지를 판별할 공통의 분류 체계를 한국의 의료계가 주도적으로 제시한 적은 필자가 알기로는 아직 없다. 미국에서 이 작업을 선도적으로 수행한 주체가 정부나 의회가 아니라, 의사협회의 CPT 편집위원회였다는 사실을 기억할 필요가 있다.
이러한 공백이 가장 첨예하게 드러날 지점은 다름 아닌 수가이다. 한국의 건강보험 상대가치점수 역시 미국의 자원기준 상대가치점수 체계(RBRVS)를 참고하여 만들어졌기 때문에, 의사 업무량, 진료비용, 위험도라는 같은 세 가지 요소로 구성되어 있다. 그렇기 때문에 92229에서 벌어진 일은 결코 남의 이야기가 아니다. 자율 인공지능이 수행한 행위에 수가를 매기는 순간, ‘의사 업무량’ 에 무엇을 적을 것인가라는 질문은 조만간 한국에서도 똑같이 나올 것이다. 만약 0이라고 적는다면 그것은 이 행위에 의사의 임상적 판단이 없다는 공식적인 선언이 될 것이고, 0이 아니라고 적으려면 감독과 검증과 최종 판단이라는 의사의 노동을 어떻게 계량할 것인지부터 정의되어야 한다.
제도가 먼저 완성되고 나면, 의료계는 그 제도에 ‘대응하는’ 위치에 서게 될 것이다. 이러한 체계를 앞장서서 만들고 기준을 먼저 제시하는 쪽이 논의의 주도권을 가질 것이다. 미국의사협회는 그것을 알고 있었고, 그래서 일찍이 2021년부터 움직였다.
더 중요한 질문으로 넘어가야 할 때
앞으로 의료계가 마주할 가장 중요한 질문은 인공지능을 반대할 것인가, 받아들일 것인가가 아닐 것이다. 인공지능이 의사를 대신해 의료 행위의 일부를 수행하는 현실은 이미 시작되었고, 그 범위와 자율성의 정도는 앞으로도 계속 빠르게 확장될 것이다. 이제 더 중요한 것은 인공지능이 수행하는 행위를 어떻게 정의할 것인지, 어느 수준까지 자율성을 허용할 것인지, 그 판단과 결과에 대한 책임을 누구에게 어떻게 배분할 것인지, 그리고 그 행위의 가치를 어떠한 기준으로 평가하고 보상할 것인지를 정하는 일이다.
이러한 질문에 대한 답은 기술이 저절로 만들어주지 않는다. 정부나 산업계가 대신 정해줄 때까지 기다려서도 안 된다. 의료 행위의 성격과 위험, 책임과 가치를 가장 깊이 이해하고 있는 의료계가 먼저 개념을 정의하고, 분류 체계를 만들며, 검증과 위임의 원칙을 제시해야 한다.
최근 오픈AI가 챗GPT 아스트라를 공개하며, 이제 인공지능이 AGI, 즉, 사람처럼 사고하는 일반 인공지능의 수준에 도달했음을 천명했다. 인공지능은 여기에 그치지 않고 앞으로 더욱 빠르게 발전할 것이다. 의료 역시 이러한 인공지능의 발전에 정면으로 영향을 받을 것이다. 이는 한 편으로는 여러 급격한 변화를 야기할 위기임과 동시에, 또 한 편으로는 그동안 꿈꿔왔던 정밀의료, 예방의료 등 의료가 궁극적으로 지향해왔던 목표를 이루기 위한 기회이기도 하다.
이러한 결정적인 순간에 새로운 기술을 설명하기 위한 언어와, 분류하기 위한 기준, 어떻게 이를 받아들이고 활용할 것인지에 대한 제도적인 프레임워크를 만드는 사람이 의료의 미래를 주도하게 될 것이다. 이제는 ‘인공지능이 의사를 대체할 것인가’라는 단편적이고도 이미 의미가 없어진 질문을 붙잡고 있는 것에서 벗어나, 더 중요한 질문에 답하는 것이 중요하고도 시급한 상황이다.

글쓴이
최윤섭
디지털 기술과 생명과학, 의학의 융합을 통해 사회적 가치를 창출하고 의료를 혁신하는 것을 화두로 삼고 있는 디지털 헬스케어 전문가, 미래의료학자, 작가, 벤처투자자입니다. 포항공과대학교(POSTECH)에서 컴퓨터공학과 생명과학을 복수전공하였으며, 전산생물학으로 이학박사 학위를 취득하였습니다. Stanford University 방문연구원, 서울대학교병원 연구조교수를 역임하였습니다. 현재 디지털 헬스케어 스타트업 전문 투자사 디지털 헬스케어 파트너스(DHP)의 대표 파트너이며, 연세대학교 의과대학 예방의학교실 외래조교수이기도 합니다. 『디지털 헬스케어: 의료의 미래』, 『의료 인공지능』, 『헬스케어 이노베이션』 등을 집필하였으며, Science의 제1저자를 비롯해서, 주요 국제 학술 저널에 다수의 논문을 개제하였습니다. npj Digital Medicine Editorial Board 멤버이자, 대한의료인공지능학회 설립 발기인 및 기획이사로 활동했습니다. 식약처 및 심평원의 자문위원이기도 합니다.
최윤섭의 디지털 헬스케어에서 더 알아보기
구독을 신청하면 최신 게시물을 이메일로 받아볼 수 있습니다.